LlamaFactory:零代码微调100+大模型的开源平台
hiyouga/LlamaFactory ·
零代码微调100+主流LLM/VLM的一站式工具,支持LoRA/QLoRA/RLHF等全链路训练,配备Web界面和CLI,已被亚马逊/英伟达等采用
成熟度:维护活跃,最近提交4天前,open issues 1067个,已获ACL 2024收录,商业级采用案例
项目体检
技术 · Python 3.11+ + PyTorch 2.4+ + Transformers 4.55+ + Gradio 4.38+ (Web界面) + PEFT/TRL训练库
许可 · Apache-2.0,允许商用且无需开源修改,可自由集成到商业产品
活跃 · 极活跃:最新版本v0.9.5发布于2个月前,286位贡献者持续维护,4天前仍有代码提交
LlamaFactory 是一个简单易用且高效的大型语言模型训练与微调平台,由 GitHub 用户 hiyouga 维护的开源社区项目(仓库 hiyouga/LlamaFactory),不是某一家模型厂商的闭源官方控制台,而是面向本地与云端训练场景的第三方开源工具。
它主要解决「想在自己环境里微调上百种预训练模型、又不想从零写训练代码」的问题,适合需要本地或自托管微调、对齐与导出的研究者、工程团队与爱好者。最关键的使用边界是:能力与成本高度依赖你自己的 GPU/NPU 与数据条件,项目本身提供的是训练与部署工具链,而不是包干式的托管微调 SaaS 标价方案。
核心能力可概括为:通过零代码命令行与 WebUI(LLaMA Board)做持续预训练、多模态指令监督微调、奖励模型与 PPO/DPO/KTO/ORPO 等对齐训练,并支持 LoRA/QLoRA、多后端推理导出以及 OpenAI 风格 API 部署。
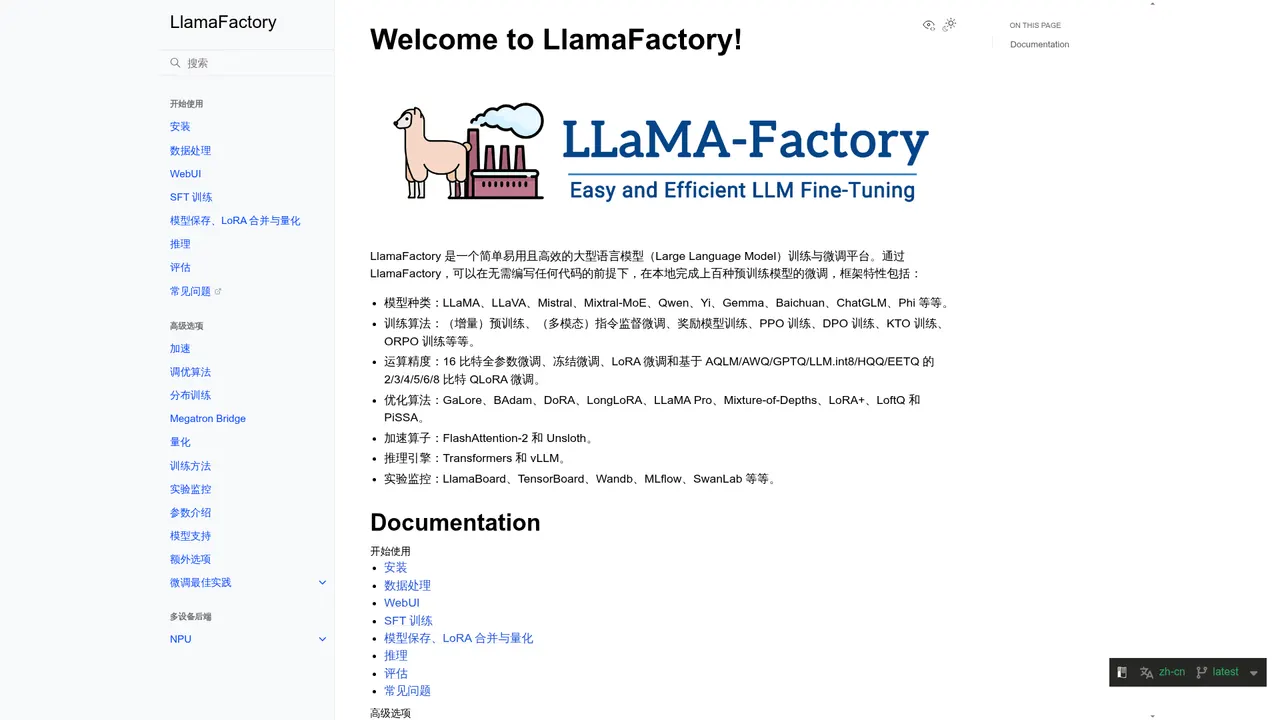 LlamaFactory 官网首页整页截图
LlamaFactory是什么?谁开发的是否官方项目?
LlamaFactory 官方中文文档的定位是:简单易用且高效的大型语言模型(Large Language Model)训练与微调平台,可在无需编写任何代码的前提下,在本地完成上百种预训练模型的微调。
GitHub README 的概括是:轻松微调 100+ 大型语言模型,提供零代码命令行(CLI)和 Web UI,并强调对前沿模型族的 Day-N 微调支持。仓库地址为 https://github.com/hiyouga/LlamaFactory,主页指向 https://llamafactory.readthedocs.io。
它是开源社区项目,不是单家闭源「官方控制台」。README 提到已被 Amazon、NVIDIA、Aliyun 等使用。v0.9.4 起仓库名由 LLaMA-Factory 更新为 LlamaFactory,与旧称指向同一项目演进线。
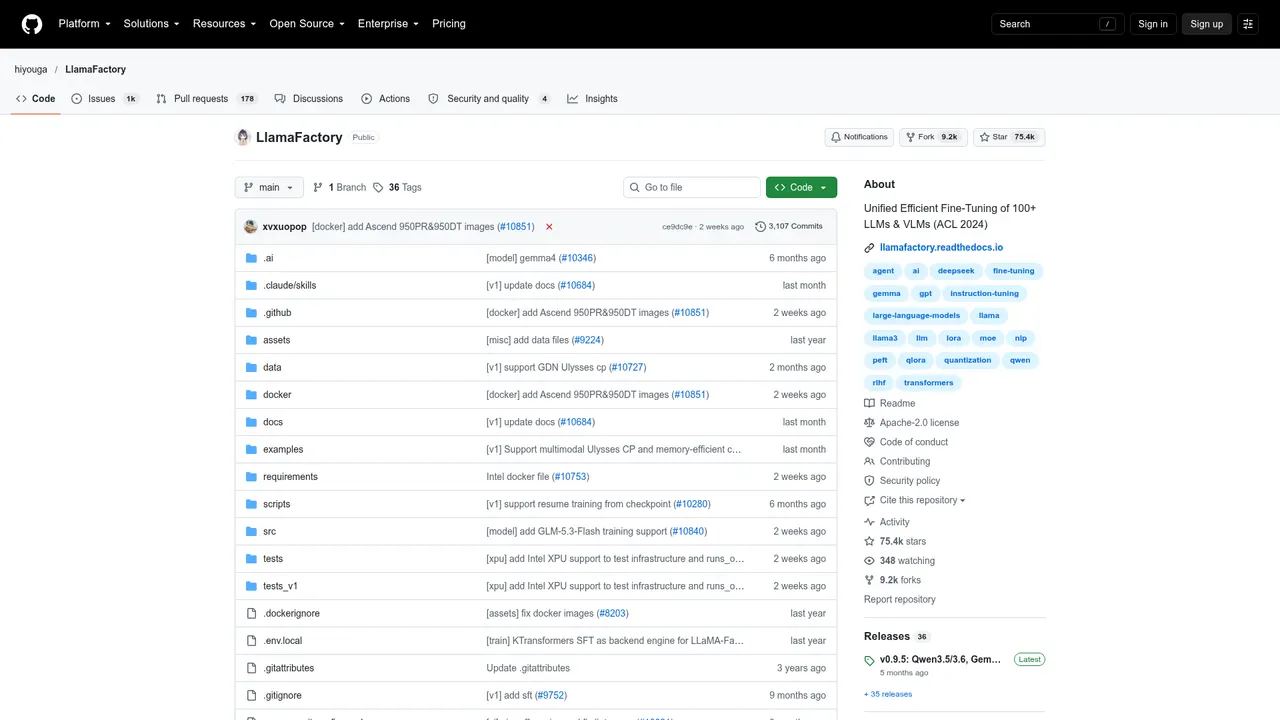 LlamaFactory GitHub 仓库页整页截图
项目还提供技术说明、AMD GPU 文档、昇腾 NPU 文档与官方博客等学习入口,并设有微信与 NPU 用户社群。英文文档页面被明确标注为进行中(WIP)。
LlamaFactory开源许可证是什么?可以商用吗?
GitHub 仓库登记的许可证为 Apache-2.0。最新发布版本为 v0.9.5。
官方页面没有列出定价与独立「商用授权套餐」:项目以开源仓库与文档站点分发,不在同一页面上再列一套付费授权价目。是否符合你的商用合规要求,需要直接阅读 Apache-2.0 许可文本,并结合你方数据、模型权重与部署环境的第三方条款自行判断。
README 还提醒:除列出的官方链接外,其他网站均为未经授权的第三方网站,请谨慎使用。这与许可证是不同层面的风险——第三方镜像或「李鬼」站点可能夹带不明改动。
LlamaFactory能做什么?真能零代码微调100+大模型吗?
官方称可以在无需编写任何代码的前提下,在本地完成上百种预训练模型的微调;README 同步写明零代码命令行与 Web UI。这里的「零代码」指常规微调流程可通过命令行参数/配置与 WebUI 完成,而不是完全不能扩展代码。
已支持的模型族(文档与 README 列举)包括:
- LLaMA、LLaVA、Mistral、Mixtral-MoE
- Qwen / Qwen3 / Qwen3-VL、DeepSeek、Yi、Gemma、GLM、Baichuan、ChatGLM、Phi 等
- Day 0 级支持示例:Qwen3、Qwen2.5-VL、Gemma 3、GLM-4.1V、InternLM 3、MiniCPM-o-2.6
- Day 1 级支持示例:Llama 3、GLM-4、Mistral Small、PaliGemma2、Llama 4
训练与对齐方法包括:
- (增量)预训练、(多模态)指令监督微调
- 奖励模型训练、PPO、DPO、KTO、ORPO
- 发布说明中还提到 MPO、FP8 训练等路径
参数高效与节省显存相关选项包括:
- 16-bit 全参数微调、冻结微调、LoRA
- 2/3/4/5/6/8-bit QLoRA(经 AQLM/AWQ/GPTQ/LLM.int8/HQQ/EETQ 等)
- 进阶算法:GaLore、BAdam、APOLLO、Adam-mini、Muon、OFT、DoRA、LongLoRA、LLaMA Pro、Mixture-of-Depths、LoRA+、LoftQ、PiSSA 等
- 加速与技巧:FlashAttention-2、Unsloth、Liger Kernel、KTransformers、RoPE scaling、NEFTune、rsLoRA 等
任务面覆盖: 多轮对话、工具调用、图像理解、视觉定位、视频识别、音频理解等。对多数模型,可用工具调用数据集做智能体调优(agent tuning),为模型配备工具使用能力;也可使用 Glaive Function Calling V2(en&zh)等工具调用数据。
监控: LlamaBoard、TensorBoard、Wandb、MLflow、SwanLab 等。
若需要接入自定义模型,文档说明可在 src/llamafactory/data/template.py 用 register_template 注册模板,在 src/llamafactory/extras/constants.py 提供下载路径;多模态还可涉及 src/llamafactory/data/mm_plugin.py,并支持 ModelScope 等下载源。
如何快速安装LlamaFactory并启动WebUI做零代码微调?
v0.9.4 起安装方式由 pip 迁到 uv,发布说明给出的安装命令为:
uv pip install llamafactory
含义简述:
uv:发布说明要求使用的安装工具链(自 pip 迁移而来)pip install:在 uv 管理的环境中安装包llamafactory:要安装的项目包名
部分数据集使用前需要确认授权,README 建议先登录 Hugging Face 账号:
pip install "huggingface_hub<1.0.0"
huggingface-cli login
huggingface_hub<1.0.0:安装低于 1.0.0 的 Hub 客户端huggingface-cli login:写入账号凭证,以便访问需确认的数据集
环境版本(README 表格):
| 组件 | 最低 | 推荐 |
|---|---|---|
| torch | 2.0.0 | 2.6.0 |
| transformers | 4.49.0 | 4.50.0 |
| CUDA(可选平台) | 11.6 | 12.2 |
README 还列出 deepspeed、bitsandbytes、vllm、flash-attn 等可选运行时依赖的最低/推荐版本,安装加速或量化后端前应按当前 README 表格核对。
v0.9.4 起需要 Python 3.11–3.13(3.9–3.10 已弃用)。若最新特性不可用,README 说明应拉取最新代码并重新安装。某些模型需从 main 分支安装 transformers,并使用 DISABLE_VERSION_CHECK=1 跳过版本检查。
启动 WebUI(LLaMA Board):
README 写明开发了一体化 Web UI(all-in-one Web UI),用于训练、评估与推理;GUI 路径称为 LLaMA Board(基于 Gradio)。安装 llamafactory 包之后,即可按 README 中「Fine-Tuning with LLaMA Board GUI」路径进入浏览器界面,在页面上选择模型、数据集与微调方法,而不必先写训练脚本。
官方公开说明里强调的是「安装后通过 LLaMA Board / Gradio 做零代码微调」这一结果,本地训练与云端训练都是文档写明的用法。另支持 Docker 构建;v0.9.3 起提供官方 GPU Docker 镜像。云端入口包括 Colab(免费)、PAI-DSW(免费试用)、AMD GPU Cloud(免费额度)。
模板必须一致: 基座模型可选 default、alpaca、vicuna 等;指令/对话模型务必使用对应模板;训练与推理要使用同一模板。可在 template.py 添加自定义聊天模板。若模型同时存在推理(reasoning)与非推理(non-reasoning)版本,使用 _nothink 后缀区分。推理模型另有 enable_thinking 参数。
怎样用LoRA/QLoRA高效微调Qwen/DeepSeek?数据准备到训练完整演示
Qwen、DeepSeek 均在 README 支持列表中。资源高效路径明确包含 LoRA 与 2/3/4/5/6/8-bit QLoRA。下面以官方 README 可核对的「工具调用智能体调优(agent tuning)+ LoRA/QLoRA」最小 SFT 为例,写清输入、关键配置字段、步骤与得到的结果(不编造未公布的损失或准确率)。
以 glaive_toolcall_en 工具调用数据做 LoRA 监督微调为例
1. 输入(训练前准备好的对象)
| 项 | 取值(文档可核对) |
|---|---|
| 模型 | README 支持列表中的指令/Chat 版,例如 Qwen3 或 DeepSeek 系指令模型 |
| 数据集 | dataset: glaive_toolcall_en(README 写明:通过该工具调用数据为多数模型做 agent tuning,配备 tool using 能力) |
| 模板 | 与该指令/Chat 模型对应的模板;基座才用 default / alpaca / vicuna 等 |
| 算法 | LoRA,或 2/3/4/5/6/8-bit QLoRA(经 AQLM/AWQ/GPTQ/LLM.int8/HQQ/EETQ) |
| 训推约定 | 训练与推理使用同一模板(README:Remember to use the SAME template) |
2. 安装与数据访问(先得到可运行环境)
uv pip install llamafactory
若数据集需要 Hugging Face 确认:
pip install "huggingface_hub<1.0.0"
huggingface-cli login
也可按 README 从 ModelScope Hub 或 Modelers Hub 下载模型与数据。
3. 关键配置字段(写入训练配置 / 命令行参数)
一次最小可核对配置应至少固定这些字段(字段名来自 README/文档):
### 模型与数据
model_name_or_path: <Qwen3 或 DeepSeek 指令模型路径或 Hub 名>
dataset: glaive_toolcall_en
template: <与该指令模型对应的模板名>

### 高效微调
finetuning_type: lora          # 或走 QLoRA 量化路径
# QLoRA 时再配合 AQLM/AWQ/GPTQ/LLM.int8/HQQ/EETQ 等量化后端

### 可选省显存 / 长文本 / 大数据开关(按需)
# streaming: true
# max_steps: 10000
# neat_packing: true
# shift_attn: true
# rope_scaling: linear          # 训练阶段;推理改 dynamic
说明:
dataset: glaive_toolcall_en:官方写明的工具调用智能体调优数据字段template:指令模型必须用对应模板;PaliGemma 这类预训练模型则需paligemma模板才能较好用于对话补全finetuning_type: lora/ QLoRA:对应支持表中的 LoRA、QLoRA 列- 若模型同时有推理与非推理版本,用
_nothink后缀区分;推理模型可加enable_thinking - 中文文档入门路径覆盖 SFT 训练;本地训练入口见 README 的 Start local training
4. 启动训练并监控
按 README「Start local training」或中文文档「SFT 训练」启动后:
- 过程可用 LlamaBoard、TensorBoard、Wandb、MLflow、SwanLab 查看曲线
- 发布说明支持 early-stopping,验证指标不再提升时可提前结束
- 得到的直接结果:可保存的 LoRA 适配器 / 检查点(不是固定榜单分数)
5. 保存、合并、导出与推理(输出物)
按入门文档「模型保存、LoRA 合并与量化」继续:
- 保存检查点,必要时做 LoRA 合并与量化
- 导出检查点时可保存 Ollama modelfile,便于转到 Ollama 侧加载
- 推理走 OpenAI 风格 API、Gradio UI 或 CLI;worker 可选 vLLM 或 SGLang
- 配置
infer_backend: vllm时,官方称可获得约 270% 的推理速度 - demo API 已对齐 OpenAI 格式,便于接到现有 Chat 应用
6. 本示例结束后你应拿到的结果清单
| 结果 | 说明 |
|---|---|
| LoRA/QLoRA 检查点 | SFT 正常结束的直接产物 |
| (可选)合并后权重 | 经「LoRA 合并与量化」得到 |
| Ollama modelfile | 导出检查点时官方支持保存 |
| 可调用的推理服务 | OpenAI 风格 API + vLLM 或 SGLang;或 Gradio UI / CLI |
| 能力倾向 | README 对 glaive_toolcall_en 的表述:为模型配备工具使用(tool using)能力 |
显存与规模相关的官方参考(估算,非你机器上的保证值):
- 全量
bf16/fp16:硬件表为估算(estimated),7B 约 120GB、14B 约 240GB - FSDP+QLoRA:可在 2×24GB GPU 上微调 70B
- Unsloth:官方描述有 Llama-2-7B-56k within 24GB,并称相对 FlashAttention-2 可到 117% 速度、50% 显存
- KTransformers:官方称可在 2×4090 GPU + CPU 场景探索 1000B 级微调
- v0.9.5 支持 FSDP2、用
ray.remote启动分布式;v0.9.4 支持 DeepSpeed AutoTP
若最新特性不可用,README 说明应拉取最新代码并重新安装。另有 vLLM-ascend、昇腾 NPU、Megatron Bridge / mcore_adapter 等进阶后端,可按硬件替换,不改变「glaive_toolcall_en → LoRA/QLoRA SFT → 导出 → API 推理」主链。
RLHF/DPO等对齐训练在LlamaFactory里如何配置与避坑?
LlamaFactory 把对齐相关能力写进同一套平台,而不是只做 SFT。
文档与 README 对齐相关能力:
- 奖励模型训练
- PPO 训练
- DPO 训练
- KTO 训练
- ORPO 训练
- 发布说明中的 MPO 算法支持
配置时建议抓住的边界:
-
先 SFT 再对齐的数据与模板一致
训练/推理模板必须相同;指令模型要用对应模板,避免「对齐阶段换模板」导致对话格式漂移。 -
方法列在支持表中,不代表每条模型线都有完整复现教程
社区 issue 中有人提出结合 GRPO 复现 DeepSeek-R1 类推理模型、向 huggingface open-r1 看齐的需求(#6792),说明强化学习/推理模型复现仍是高频讨论区,而不是「一键等于论文全套」。 -
yaml 与命令行如何同时用
有用户提问如何同时使用 yaml 与 CLI 参数(#5830)。若你的复现依赖大量超参,需要事先理清覆盖优先级,避免被另一侧参数悄悄覆盖。 -
多模态与 VLM 对齐/微调的细节
存在 LLaVA 实现严重不对齐的讨论(#6008),以及 VLM 上为视觉编码器与语言骨干设置不同学习率的需求(#5831)。做多模态奖励建模或偏好对齐前,应先验证视觉侧输入链路。 -
导出合并后再服务
有报告显示合并 LoRA 后的 GPT-OSS 20B 在 vLLM 服务部署时出现 KeyError(#8969)。对齐后的服务路径(合并权重 / 适配器加载 / 推理后端)要单独冒烟,不能默认「训练成功=服务成功」。 -
功能型偏好与工具调用
需要更通用函数调用(function call)方式的讨论仍在进行(#8351)。工具调用数据(如 Glaive 系列)与 DPO/PPO 偏好数据是不同目标,不要混成同一套指标。
LlamaFactory自托管成本高吗?有云版吗多少钱?
LlamaFactory 本身以开源本地/自托管为主;README 同时给出「云端训练」入口,但那些是 Colab、PAI-DSW、AMD GPU Cloud 等外部算力环境,不是项目页面上的一档固定「LlamaFactory 企业版月费」。官方没有列出独立托管微调定价表,因此下表只整理已写明的使用路径与费用属性,不把外部云的隐性账单写成官方套餐价。
| 方案 | 价格 | 关键额度 | 适合谁 |
|---|---|---|---|
| 本地自托管 | 开源使用;算力自备 | 视自有 GPU/NPU;全参 7B 估算约 120GB 级显存 | 有机器、要数据本地化的团队 |
| Colab | 页面标注免费 | 有免费 T4 微调 Llama-3 的 notebook 说明 | 试用流程、学生与入门 |
| PAI-DSW | 免费试用 | 试用额度以平台为准 | 想在阿里云系环境试跑的人 |
| AMD GPU Cloud | 免费额度 | 赠金/积分以平台为准 | 有 AMD 资源或想用其赠金的人 |
表后补充:
- 硬件表带有估算(estimated)标注:全参数微调(Full,bf16 或 fp16)在表中对应 7B→120GB、14B→240GB 等估算,不能当成你机器上的保证值
- 降成本常用路径:LoRA/QLoRA、FSDP+QLoRA(官方描述 70B @ 2×24GB)、Unsloth、KTransformers、量化导出、vLLM/SGLang 推理
- v0.9.3 支持 S3/GCS 云数据;适合数据在对象存储、训练在云主机的拆分架构
- 昇腾 NPU 有安装配置、训练、分布式与性能优化文档,可把成本从单一 NVIDIA 供给里挪出一部分
- 官方页面没有提供按 token 计费的托管微调价目;若需要托管式 API 微调,那是与 OpenAI 等云厂商方案的对比问题(见下文)
LlamaFactory中文支持怎么样?界面文档和中文模型友好吗?
中文友好度整体较高,尤其适合主要工作语言为中文的用户。
- GitHub README 提供 English | 中文 切换
- 中文文档站点: https://llamafactory.readthedocs.io/zh-cn/latest/
- 博客资源有英文与中文
- 预训练数据示例含 Wikipedia(zh)、SkyPile zh
- SFT 数据含 Identity(en&zh)、Glaive Function Calling V2(en&zh)等
- 支持 Qwen、Baichuan、ChatGLM、Yi、DeepSeek 等中文场景常见模型族
- README 提及基于 Llama-3、用 LlamaFactory 微调的中文衍生模型相关 Colab 笔记
- 社区含微信与 NPU 用户群,对中文用户沟通成本更低
相对不足:英文文档仍标 WIP;若你只阅读英文页,可能遇到进度落后于中文页或 README 的情况。界面主体 LLaMA Board 基于 Gradio,具体 UI 文案语言以你安装版本为准;功能说明优先以中文文档与中文 README 为准更稳妥。
LlamaFactory能替代OpenAI Fine-tuning API吗?与Cohere、Anthropic Custom Models有何区别?
能否「替代」取决于你要替代的是训练控制权还是托管与合规一站式服务。LlamaFactory 强项是本地/自托管、模型面广、算法与量化选项多、可导出到 OpenAI 风格 API 或 vLLM;云厂商 Fine-tuning API 强项通常是免运维、与其生态账号/结算/内容策略绑定。
| 维度 | LlamaFactory | OpenAI Fine-tuning API | Cohere Fine-tuning | Anthropic Custom Models |
|---|---|---|---|---|
| 产品形态 | 开源训练与微调平台,CLI + WebUI | 一般特点:云端微调与推理 API 生态 | 一般特点:企业向云端 NLP/LLM 微调与部署 | 一般特点:面向定制模型的云端合作/托管路径 |
| 模型范围 | 100+ 本地预训练模型族,Day-N 跟新 | 一般特点:以自家模型与开放接口为主 | 一般特点:以自家模型线为主 | 一般特点:以自家模型定制为主 |
| 算法自由度 | SFT、全参/冻结/LoRA/QLoRA、PPO/DPO/KTO/ORPO 等 | 一般特点:提供平台规定的微调范式 | 一般特点:提供平台规定的微调范式 | 一般特点:定制流程由厂商方案定义 |
| 数据与部署位置 | 可本地完成微调;也支持云端笔记本/DSW 等 | 一般特点:数据与训练在厂商云侧 | 一般特点:数据与训练在厂商云侧 | 一般特点:数据与训练在厂商云侧 |
| 推理集成 | OpenAI 风格 API、vLLM、SGLang、Ollama modelfile 等 | 一般特点:与自家 Chat/Completions 生态衔接 | 一般特点:与自家 API 生态衔接 | 一般特点:与自家 API/企业方案衔接 |
| 费用模式 | 软件开源;成本主要在自有或租用算力 | 一般特点:按厂商计费项结算 | 一般特点:按厂商计费项结算 | 一般特点:企业合同/方案报价 |
| 运维责任 | 需自管环境、依赖、显存与并发 | 一般特点:厂商侧托管 | 一般特点:厂商侧托管 | 一般特点:厂商侧托管 |
竞品信息以各家官网为准。
粗选型建议:
- 要私有域数据不出机房、要 Qwen/DeepSeek 等多元基座、要 DPO/PPO/QLoRA 细控 → 更贴近 LlamaFactory
- 要零硬件、要与现成 Chat 应用账单一体、接受只能在厂商模型与条款内微调 → 更贴近各家 Fine-tuning / Custom Models
- 中间态:用 LlamaFactory 在 Colab/PAI-DSW/自有 GPU 训练,再用 OpenAI 风格 API 把模型接到现有 Chat 应用,减少业务侧改接口的成本
LlamaFactory有哪些局限与常见坑?
已知问题与局限
GRPO/推理模型复现仍是高关注缺口:社区希望结合 GRPO 支持 DeepSeek-R1 等推理模型复现、对齐 open-r1 类效果,讨论热度高。跟进见 #6792。
yaml 与命令行参数混用易迷糊:有人不清楚如何同时使用 yaml 与 CLI。合并配置时要自行验证最终生效值。见 #5830。
LLaVA 实现存在严重不对齐报告:多模态用户需额外验证训练与推理一致性,不能默认视觉对话已对齐。见 #6008。
Qwen3-VL SFT 报错有人踩中:sft 微调 Qwen3-vl-8B-Instruct 的错误反馈仍在讨论。上新视觉模型建议先小数据冒烟。见 #9277。
Unsloth 加速可能直接报错:启用 unsloth 加速时有失败案例,需准备好回退到非 Unsloth 路径。见 #7177。
混合图文增量预训练仍有人在问:有人询问未来是否支持混合图文数据的多模态增量预训练。若你的主流程是「图文继续预训练」而非指令 SFT,要先评估现状是否够用。见 #7581。
LoRA 合并后 vLLM 服务可能 KeyError:合并 LoRA 的 GPT-OSS 20B 在 vLLM 服务部署时报 KeyError 有记录,导出与服务部署要分阶段验证。见 #8969。
cutoff_len 对超长样本的处理方式有人不满:有建议希望 cutoff_len 可选择直接丢弃过长样本。见 #3995。
硬件数字是估算值,全参门槛高:硬件表带有估算(estimated)标注,全参数微调显存门槛高(如 7B 约 120GB、14B 约 240GB 量级),不能当成你机器上的保证值;显存不够应改走 LoRA/QLoRA 等路径。
英文文档仍在进行中:英文文档标为 WIP,中英文信息不一定同步;优先对照中文文档与 README 更稳妥。
第三方网站需谨慎:除官方链接外的第三方网站被明确提醒需谨慎,避免下载到夹带不明改动的镜像。
部分数据集有访问门槛:部分数据集必须先完成 Hugging Face 确认并登录,否则训练前会卡在数据访问。
模板与推理开关用错会导致行为差异:训练与推理模板必须一致;reasoning / _nothink / enable_thinking 用错会改变模型行为,需与模型版本匹配。
运行环境版本已抬升:v0.9.4 起 Python 3.9–3.10 已弃用,项目要求 Python 3.11–3.13,请优先使用 3.11–3.13;安装链已迁到 uv,仍用旧方式可能装到过期环境。
LlamaFactory适合谁?个人研究者还是企业团队?
更适合:
- 个人研究者与学生:可用 Colab 免费 T4 notebook、QLoRA/LoRA 在消费级显卡上做 SFT/DPO 实验
- 开源模型应用开发者:需要 Qwen、DeepSeek、Llama、Gemma、GLM 等快速跟进(含 Day 0/Day 1 支持叙述)
- 企业算法/平台团队:要数据本地训练、昇腾 NPU 或 AMD 路径、FSDP/DeepSpeed/Megatron 等扩展,并最终用 OpenAI 风格 API 对内服务
- 多模态与工具调用试验者:图像/视频/音频理解、工具调用数据集上的智能体调优(agent tuning)等
需要谨慎评估的人:
- 完全不想碰环境与显存、只想按次买托管微调的业务方——更应直接看云厂商 Fine-tuning
- 期望「打开网页=论文级 RL 全自动复现」的用户——对齐算法已支持,但复现深度与模型线仍要自备经验
- 只认单一英文企业支持合同的采购场景——本项目是 Apache-2.0 开源社区形态,需自建支持体系
README 写明被 Amazon、NVIDIA、Aliyun 等使用,说明企业落地案例存在;但这不等于提供与商业 API 同构的 SLA 页面。
FAQ
LlamaFactory免费吗?
软件以开源方式提供,可本地安装使用。云端侧文档列出了 Colab(免费)、PAI-DSW(免费试用)、AMD GPU Cloud(免费额度)等入口。真正花钱的大头通常是你自备或租用的 GPU/NPU 与存储,而不是页面上的某一档「LlamaFactory 订阅费」;官方没有列出独立托管微调定价表。
LlamaFactory支持哪些模型?
中文文档列举含 LLaMA、LLaVA、Mistral、Mixtral-MoE、Qwen、Yi、Gemma、Baichuan、ChatGLM、Phi 等;README 还写到 Qwen3、Qwen3-VL、DeepSeek、GLM 等。v0.9.5 增加对 Qwen3.5/Qwen3.6/Gemma4 的主要支持(primary support),并兼容 Transformers v5。具体能否上某一种量化或后端,仍要以当前版本说明为准。
LlamaFactory WebUI怎么用?
项目提供一体化 Web UI,GUI 称为 LLaMA Board,基于 Gradio,用于训练、评估与推理。使用 uv pip install llamafactory 安装后,按 README 中「Fine-Tuning with LLaMA Board GUI」路径即可在浏览器里选择模型与数据做零代码微调。监控还可与 LlamaBoard、TensorBoard、Wandb 等联动。
LlamaFactory和LLaMA-Factory是同一个项目吗?
是同一项目的命名演进。v0.9.4 发布说明写明:仓库名由 LLaMA-Factory 更新为 LlamaFactory。旧文档里的 LLaMA-Factory 一般即今天的 LlamaFactory。
LlamaFactory能做全参数微调吗?
能。支持表含全参数微调(Full-tuning),并有 16-bit 全参数微调描述。代价是显存高:硬件估算表中 Full(bf16 或 fp16)对 7B/14B 给出 120GB/240GB 量级。显存不够时应改用 LoRA/QLoRA、冻结微调或 FSDP/QLoRA 等。
LlamaFactory显存不够怎么办?
可改用 LoRA 或 2/3/4/5/6/8-bit QLoRA;尝试 Unsloth、量化后端、neat_packing、流式数据集;或按官方描述用 FSDP+QLoRA 在双 24GB 卡上冲击 70B 级。KTransformers 路径官方称可探索 2×4090 + CPU 的 1000B 级模型微调。推理阶段改用 vLLM/SGLang 也有助于把「训练成功但服务爆显存」分开优化。
LlamaFactory支持多GPU吗?
支持分布式相关路径:v0.9.5 支持 FSDP2、用 ray.remote 启动分布式训练;v0.9.4 支持 DeepSpeed AutoTP;另有 NPU 分布式训练文档与 Megatron Bridge / mcore_adapter 等后端。双卡 FSDP+QLoRA 微调 70B 是官方 changelog 明确写过的能力叙述。
LlamaFactory微调后的模型怎么导出与部署?
入门文档覆盖模型保存、LoRA 合并与量化。导出检查点时可保存 Ollama modelfile。部署上可使用 OpenAI 风格 API,并结合 vLLM;也支持 SGLang 后端,以及 Gradio UI 与 CLI 推理。项目还说明 demo API 已对齐 OpenAI 格式,便于接到各类 ChatGPT 式应用。
LlamaFactory和llm factory有关系吗?
目前能确认的官方入口为 hiyouga/LlamaFactory 与 llamafactory.readthedocs.io;名称相近的其他项目需另行核实,请勿将名称近似等同为同一仓库。下载与文档请以上述官方入口为准,并警惕 README 所提醒的未授权第三方网站。
LlamaFactory更新频率如何?
仓库创建于 2023-05-28,最近推送记录至 2026-09-28;星标约 75366、fork 约 9239。发布线示例:v0.9.3(2025-06-16)、v0.9.4(2025-12-31)、v0.9.5(2026-05-30)。版本节奏与模型跟进(Llama4、Qwen3、Gemma 4、Transformers v5 等)较密,但也意味着依赖与 Python 版本会阶段性抬升。
LlamaFactory官网与相关入口
- 文档主页:https://llamafactory.readthedocs.io — 项目文档入口与导航
- 中文文档:https://llamafactory.readthedocs.io/zh-cn/latest/ — 阅读中文安装、训练、NPU 与监控说明
- 英文文档:https://llamafactory.readthedocs.io/en/latest/ — 英文文档(标注 WIP)
- 自定义模型说明:https://llamafactory.readthedocs.io/en/latest/advanced/model_support.html — 注册模板与模型下载源
- GitHub 仓库:https://github.com/hiyouga/LlamaFactory — 源码、README、安装与云端入口
- Releases:https://github.com/hiyouga/LlamaFactory/releases — 版本更新与特性变更
本文信息核对至 2026 年 10 月(LlamaFactory v0.9.5)。价格与限制以官方页面为准。
参考资料
- LlamaFactory 中文文档首页
- LlamaFactory 文档主页
- LlamaFactory GitHub 仓库
- LlamaFactory 发布页(Releases)
- 自定义模型支持说明(template 与下载源)
- Issue #6792:GRPO 与推理模型复现讨论
- Issue #5830:yaml 与命令行参数同时使用
- Issue #6008:LLaVA 实现对齐问题
- Issue #9277:Qwen3-VL SFT 报错
- Issue #7177:Unsloth 加速报错
- Issue #7581:混合图文多模态增量预训练
- Issue #8969:合并 LoRA 后 vLLM 服务 KeyError
- Issue #3995:cutoff_len 丢弃过长样本的建议
安装方式:pip install llamafactory